[지식/이론] 운영체제의 프로세스 관리
참고하면 좋을 이전 글들
- “[OS] 운영체제의 구조 - 사용자 모드에서 커널 모드로 전환시키는 트리거 - Interrupt“
- “[지식/이론][python] 멀티 프로세스와 멀티 스레드”
- “[Java] 스레드 (Thread) - 스레드 개념”
- “[Java] 자바의 메모리 모델”
- “[Python] 동시성(concurrency)”
컴퓨터에서 프로그램이 실행되기까지
컴퓨터에서 프로그램이 실행되기까지의 과정을 하드웨어 관점에서 살펴보면 대략 다음과 같다.
- 프로그램은 평소 실행 코드가 담긴 실행 파일(executable file, binary file) 형태로 디스크(보조기억장치, secondary memory, auxiliary memory)에 저장되어 있다.
- 사용자가 마우스 클릭 등으로 특정 프로그램을 실행하는 명령을 내리면 디스크로부터 프로그램을 불러와 메모리(RAM1, 주기억장치2)에 적재(load)한다. 이 상태의 프로그램을 프로세스(process)라 한다. 이 프로세스 상태부터는 운영체제의 관리 대상이 된다.
- CPU(Central Processing Unit)가 프로세스가 적재된 RAM에 접근하여 프로세스를 구성하는 실행 코드, 명령어를 가져와 수행하여 프로세스가 요구하는 작업을 처리한다.
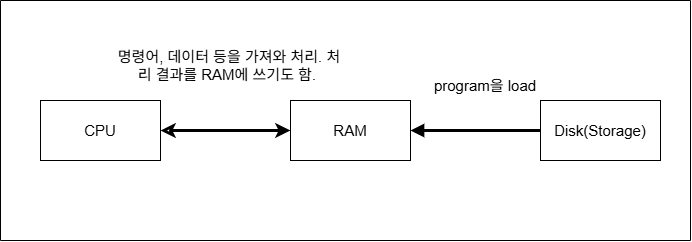
그림 1-1. 컴퓨터에서 사용자 명령에 의해 프로그램을 실행할 때 하드웨어인 CPU, RAM, Storage에서 프로그램을 실행하는 과정을 나타낸 그림.
CPU는 processor라고도 불리며, 프로세스를 실행, 처리하는 주체다. 프로세스는 CPU를 할당받아 동작 상태가 될 때 “실행 상태”에 놓이게 된다.
하나의 동일한 프로그램에서 둘 이상의 프로세스를 동시에 실행시킬 수도 있다. 프로세스의 좀 더 엄밀한 정의는 현재 실행 중인 프로그램의 “인스턴스”이다. 즉, 마치 객체 지향 프로그래밍에서 하나의 클래스로부터 여러 인스턴스들을 만들어 낼 수 있듯, 하나의 프로그램으로부터 여러 개의 프로세스들을 생성할 수 있다는 것이다.
프로세스와 스레드
디스크에 저장되어 있는 프로그램과는 달리, 메모리에 적재되어 실행 중인 프로그램을 프로세스라 한다. 프로세스는 운영체제(OS)의 관리 대상이 된다. 프로세스의 특징은 다음과 같다.
- 동시에 여러 프로세스들을 실행할 수 있으므로 이들을 구별하기 위해 각 프로세스마다 고유한 ID(PID, Process ID)가 부여된다.
- 각 프로세스들은 독립적인 메모리 영역을 할당받으며, 기본적으로는 다른 프로세스에 접근할 수 없다.
- 만약 여러 프로세스 간 통신이 필요하다면 IPC(Inter-Process Communication) 메커니즘을 사용해야한다.
프로그램이 실행 상태에 놓이기 위해 우선 프로그램이 메모리 영역을 할당받아 적재된다고 하였는데, 구체적으로는 다음과 같은 형태의 메모리 영역을 할당받는다.
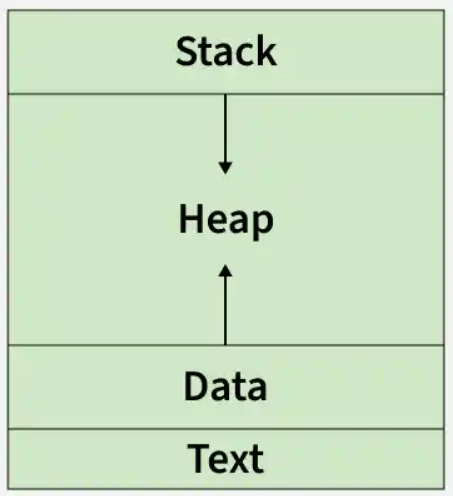
참고 사진 1-1. 프로세스가 할당받은 메모리 영역 구조.
출처: https://www.geeksforgeeks.org/operating-systems/difference-between-process-and-thread/
- Code/text: 프로그램을 구성하는 코드 및 텍스트들이 CPU가 실행 가능한 명령어 형태로 저장된다.
- Data: 코드 실행 시 사용되는 전역 변수, static 변수, 상수 등이 저장되는 영역.
- Heap: 객체와 같이 동적으로 할당되는 데이터들이 저장되는 영역.
- Stack: 코드에서 함수가 frame 단위로 스택 자료구조처럼 쌓이는 구조의 메모리 영역. 스택의 맨 끝에 있는 frame, 즉 함수가 먼저 호출되고, 맨 아래에 깔려있는 함수가 맨 나중에 실행되는 구조를 띤다. frame에는 함수와 함수 파라미터, 지역 변수 등 함수에 관한 데이터들이 임시로 저장되고, 함수가 호출되어 실행이 완료되면 해당 함수는 스택 영역에서 사라진다.
Text, data 영역은 미리 크기가 고정된 채로 할당되는 반면, stack, heap 영역은 프로세스가 실행되는 동안 그 크기가 동적으로 달라진다. 위 그림에서도 화살표를 통해 이러한 점이 표현되어 있다.
스레드(Thread)는 프로세스 내의 가장 작은 단위의 실행 흐름을 의미한다. Thread라는 용어는 본래 “실타래”라는 의미를 갖고 있기도 하기에 그림에서는 보통 구불구불한 얇은 실로 묘사하고는 한다.
스레드의 특징으로는 다음과 같다.
- 스레드도 프로세스와 마찬가지로 여러 개가 있을 수 있기에 이들을 구분하기 위해 각자 고유한 ID(TID, Thread ID)를 가진다.
- 하나의 프로세스 내에 여러 개의 스레드가 존재할 수 있다.
- 스레드는 stack 영역을 제외한 나머지 모든 메모리 영역을 하나의 프로세스 내부의 다른 스레드들과 공유한다.
- stack 영역에는 나중에 호출될 함수들이 저장되는데, 스레드들이 각자 독립적인 stack 영역을 가진다는 것은 각자 독립적인 함수 실행이 가능하다는 것이고, 이는 독립적인 실행 흐름을 가질 수 있다는 것이다. 따라서 여러 작업들이 서로를 기다리지 않고 동시에 수행되게끔 하여 작업 시간을 단축하고자 할 때 다중 스레드를 사용할 수 있다.
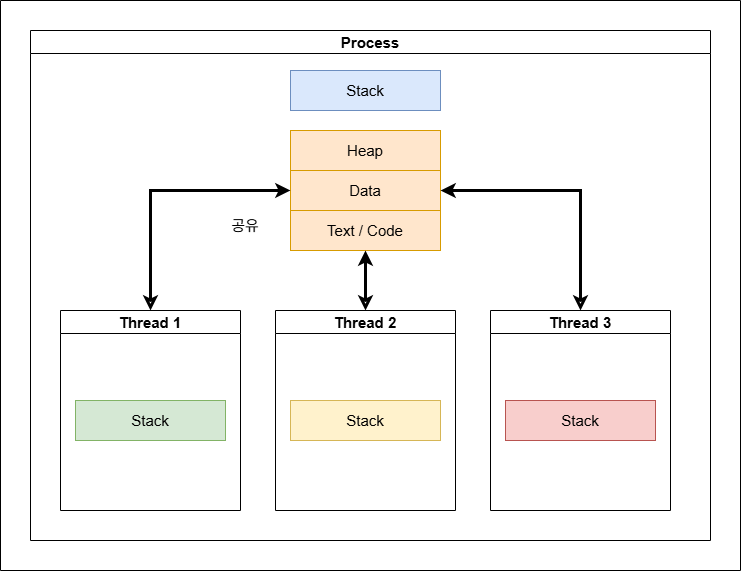
그림 2-1. 프로세스 내 다중 스레드들의 메모리 영역을 그림으로 표현하였다. 하나의 프로세스 내 여러 스레드들은 프로세스의 heap, data, text 메모리 영역은 서로 공유하나, stack 영역은 각자 스레드 고유의 영역으로 할당된다. 이로 인해 각 스레드들은 프로세스 내 일부 메모리 영역 공유를 통해 메모리 공간을 절약할 수 있으면서도 동시에 각 스레드마다 독립적인 기능을 수행할 수 있게 된다.
프로세스와 스레드의 차이점은 다음과 같이 정리할 수 있겠다.
| 속성 | process | thread |
|---|---|---|
| 정의 | 실행 중인 프로그램 | 프로세스 내에서의 가장 작은 단위의 실행 흐름. |
| 생성, 삭제에 드는 시간 | 상대적으로 오래 걸림 | 상대적으로 빠름 |
| Context switch 속도 | 상대적으로 느림 | 상대적으로 빠름 |
| 개체 간 통신 | 프로세스 간 소통을 하려면 IPC와 같은 별도의 방법이 필요하다. | 같은 프로세스 내 자원을 같이 공유하므로 상대적으로 서로 통신하는 것이 쉽다. |
이러한 이유로, 여러 작업들을 동시에 실행해야할 때에는 여러 프로세스들을 생성하는 것보단 여러 스레드들을 생성하는 것이 자원을 덜 소모하고 상대적으로 작업 처리 속도도 빨라서 웬만하면 다중 스레드로 문제를 해결하는 것이 더 좋을 것이다.
동시에 여러 프로그램을 실행시키는 방법
옛날에는 하나의 컴퓨터에서 한 번에 단 하나의 프로그램만을 실행시킬 수 있다고 한다. 그래서 동시에 여러 프로그램들을 띄워 실행시킬 수는 없었으며, 다른 프로그램을 사용하려면 먼저 현재 실행 중인 프로그램을 끄고 다른 프로그램을 실행해야 했다고 한다.
또한, 파일 입출력, 네트워크 통신, 마우스, 키보드와 같은 입출력 장치들 간의 데이터 입출력 등의 여러 I/O(Input, Output) 작업들이 존재하는데, CPU가 프로세스를 처리하는 동안 I/O 작업을 종종 마주친다. 이 때, I/O 작업 동안에는 CPU가 아무것도 하지 못한 채 해당 작업을 기다려야만 했다3. 이는 사용자가 계속 기다려야할 뿐만 아니라, CPU라는 자원을 효율적으로 사용하지 못한다는 단점으로 이어졌다.
이러한 문제를 해결하기 위해 다중 프로그래밍이란 기법이 등장하였다.
다중 프로그래밍 (Multi-programming)
다중 프로그래밍은 메모리에 단 하나의 프로세스가 아닌 여러 프로세스들을 올리고, 하나의 CPU가 이들을 번갈아가며 처리하도록 하는 기법이다. 하나의 프로세스에서 I/O 작업을 수행하는 동안 CPU는 이 작업을 기다리지 않고 그 시간에 다른 프로세스를 처리하도록 하는 것이다. 이로 인해 CPU를 한층 더 효율적으로 활용할 수 있게 되며, 사용자 입장에서도 하나의 컴퓨터에서 여러 프로그램들을 동시에 실행시킬 수 있게 되었다.
예시를 들어 다중 프로그래밍을 설명하자면 다음과 같다. 프로세스 A, B 이 두 개가 있다고 해보자. 먼저 CPU는 프로세스 A를 처리하고 있다고 해보자. 그러다가 중간에 프로세스 A에서 파일 저장 또는 로드하는 등 I/O 작업이 발생했다고 치자. 그러면 CPU는 해당 작업을 기다리지 않고 바로 프로세스 B를 처리하기 시작한다. 프로세스 B에서도 I/O 작업을 요구하면 CPU는 다시 프로세스 A로 돌아와 나머지 작업을 처리하는 구조다.
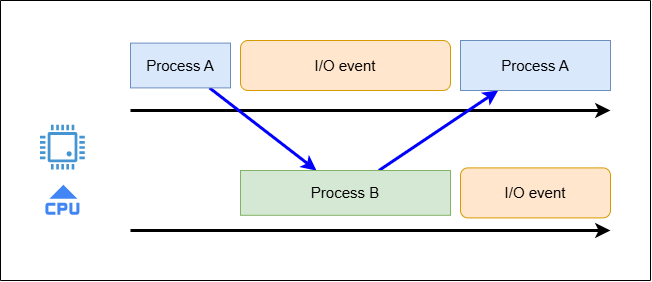
그림 3-1. 멀티 프로그래밍 예시. 두 프로세스 A, B가 동시에 실행되고 있을 때 I/O 이벤트 발생에 따라 CPU는 쉬지 않고 바로 다른 프로세스로 넘어가 처리하는 구조.
이와 같이 CPU가 어떤 프로세스를 처리하다가 다른 프로세스를 처리하는 것을 context switching(문맥 교환)이라고 한다. 이 때, CPU는 무작정 다음 프로세스로 스위칭하지 않는다. 이전 프로세스를 어디까지 처리했는지에 대한 정보를 먼저 저장한다. 이 때 PCB(Process Control Block)라는 자료구조에 이전 프로세스의 상태 정보를 저장한 후에 다음 프로세스로 전환한다. 다음 프로세스로 전환할 때에도 해당 프로세스의 PCB를 먼저 로드하여 처리한다.
이렇게 동시에 여러 프로그램들을 구동시킬 수 있게 된 다중 프로그래밍 기법에도 문제점이 발생하였다. 하나의 프로세스를 처리하는 시간이 길어질수록 다른 프로세스들은 계속 대기 상태에 놓여야한다는 것이었다. 다른 말로 하면 프로세스의 독점 문제가 발생한다는 것이다. 그러다보니 한 컴퓨터에 여러 프로그램들을 동시에 “띄우기”는 했지만 정작 다른 프로그램들은 기다림으로 인해 사실상 멈춰있는 상태가 되어버려 “여러 프로그램들을 동시에 사용한다”라는 체감이 들지 않았을 것이다. 이러한 문제를 해결하기 위해 멀티 태스킹이란 기법이 등장하였다.
멀티 태스킹 (Multi-tasking)
멀티 태스킹 기법은 CPU가 프로세스를 처리하는 시간 단위를 짧게 정하고, 정해진 시간을 지나면 CPU가 바로 다른 프로세스로 context switching하도록 하는 기법이다. 이 때의 시간 단위를 시간 할당량, time quantum, time slice라고도 부른다. 즉, 아무리 프로세스의 작업을 다 처리하지 못했더라도 할당된 시간을 지나버리면 CPU는 바로 다른 프로세스로 전환하는 것이다. 이로 인해 특정 프로세스가 CPU를 독점하는 것을 방지할 수 있다.
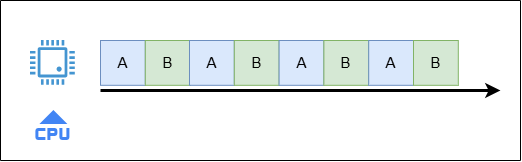
그림 4-1. 두 프로세스 A, B에 대한 멀티 태스킹 예시. 위 그림에서는 두 프로세스에 할당된 시간 할당량이 동일하다고 가정하였으며, CPU는 이 시간 동안 특정 프로세스를 처리하고 그 시간이 지나면 바로 다른 프로세스로 넘어가 처리하는 구조를 띈다.
멀티 프로그래밍에 비해선 더 자주 context switching을 수행해야하기에 언뜻 보면 더 느릴 것 같기도 하지만, CPU가 context switching하고 명령어를 수행하는 속도가 매우 빠르기에 사람이 보기에는 하나의 CPU가 동시에 여러 프로세스들을 실행시키는 것처럼 보인다. 이로 인해 하나의 컴퓨터에 여러 프로그램들을 띄우더라도 모든 프로그램들이 느리지 않고 빠르게 실행되는 것처럼 보여 매우 빠른 반응성(responsiveness)을 보여준다.
이러한 멀티 태스킹은 동시성(concurrency)을 가능하게 한다. 동시성은 하나의 CPU가 여러 프로세스, task들을 매우 빠르게 번갈아가며 처리하여 마치 동시에 작업을 처리하는 것처럼 보이는 것을 의미한다. 매우 빠르게 번갈아가며 처리해서 그렇지, 사실 엄밀히 따지고보면 정말로 동시에 처리하는 것이라고 보기엔 힘들다.
이렇게 각 프로세스마다 시간 할당량을 두어 CPU가 번갈아가며 빠르게 처리하는 방식을 통해, 여러 사용자들이 동일한 컴퓨터 내에서 각자의 프로그램들을 동시에 사용할 수 있도록 한다. 이를 시분할 시스템(Time sharing system)이라 한다. 원리는 멀티 태스킹과 동일하지만, 목적이 “다중 사용자 지원”일 때에는 따로 “시분할 시스템’이라고 구분하는 것 같다.
CPU가 각 프로세스들을 빠르게 번갈아가며 처리하는 방식이기에, 너무 많은 프로세스들이 메모리에 적재되면 그만큼 context switching 대상이 더 많아지기에 상대적으로 속도가 느릴 수밖에 없다. 이와 동일한 원리로 인해, 보통 어떤 작업들을 순차적으로 처리하던 방식에서, 다중 스레드를 도입하면 각 작업들을 서로 기다리지 않고 비동기적으로 처리할 수 있기에 작업 속도가 무조건 빨라지지 않을까, 라는 생각을 할텐데, 스레드의 수가 너무 많아도 과도한 컨텍스트 스위칭 때문에 오히려 속도가 생각보다 더 느려질 수도 있다는 것을 유념해둬야 할 것이다45.
멀티 프로세싱 (Multi-processing)
지금까지는 하나의 CPU만을 상정하였다. 그러나 하나의 컴퓨터 내부에 아예 둘 이상의 CPU 코어(core)들을 넣어 여러 CPU 코어들이 동시에 여러 프로세스들을 처리하도록 할 수 있는데, 이를 멀티 프로세싱이라 한다. 멀티 프로세스(multi-process)는 말 그대로 다중 프로세스를 의미하는 것이므로 이 두 용어 간의 혼동을 주의해야 한다.
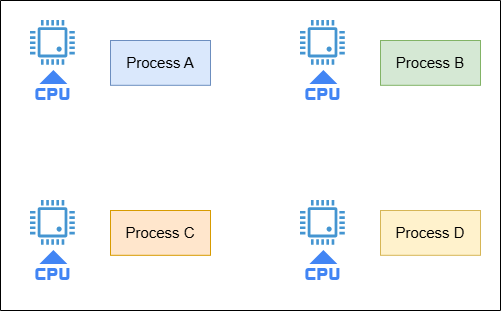
그림 5-1. 멀티 프로세싱 예시 그림. 멀티 프로세싱 방식에서는 여러 개의 CPU 코어를 동시에 사용하기에 여러 프로세스들을 각자 CPU 코어가 나눠 처리할 수 있다. 이를 통해 병렬성(parallelism)을 얻을 수 있다.
보통 컴퓨터를 구매할 때 CPU(processor)에 대해 “4코어 8스레드”와 같은 용어들을 접할 수 있는데, 이렇게 컴퓨터에 여러 CPU 코어들이 들어있다는 것은 그만큼 여러 프로세스들을 동시에 처리할 수 있다는 뜻이다.
Single CPU core를 사용하는 멀티 태스킹 기법에서는 단 하나의 CPU로 여러 프로세스들을 처리해야하는 반면, 멀티 프로세싱 기법에서는 여러 프로세스들을 여러 개의 CPU로 분산, 할당시킬 수 있어 CPU가 상대적으로 과부하를 덜 겪을 수 있으며, 처리량(throughput)을 더 높일 수 있다.
멀티 프로세싱은 병렬성(parallelism)을 가능하게 한다. 병렬성은 실제 물리적으로 동시에 여러 작업들을 수행할 수 있는 성질이다. 동시성(concurrency)은 겉으로 보기에 동시처럼 보이는 것에 반해, 병렬성은 실제로 여러 작업들을 동시에 처리한다는 점에서 다르다. 즉, 멀티 프로세싱을 이용하면 동시성을 한층 더 개선시킬 수 있으며, 병렬성도 얻을 수 있는 것이다.
멀티 프로세싱과 멀티 태스킹은 그 개념이 다르긴 하지만 그렇다고 해서 상호배타적인 개념은 아니다. 즉, 상황에 따라 두 개념을 모두 섞어 사용할 수도 있다는 것이다. 여러 개의 다중 CPU 코어들이 각자 여러 프로세스들을 할당 받아 그 안에서 context switching하며 멀티 태스킹을 하도록 고안할 수도 있다는 것이다.
다중 CPU core들을 사용한다고 하더라도, 동일한 컴퓨터 하드웨어 내에는 물리적 메모리(RAM)가 단 하나 뿐이기에 이 물리적 메모리를 공유하여 사용한다.
참고 - PCB(Process Control Block)와 TCB(Thread Control Block)
PCB(Process Control Block)는 프로세스의 정보와 실행의 관리를 위해 운영체제가 추적하기 위한 용도로 사용되는 자료 구조이다. 이 PCB 덕분에 운영체제가 프로세스들을 모니터링하고 통제할 수 있게 된다. PCB는 운영체제의 일부로 저장되며, 일반 유저들은 접근할 수 없다.
PCB에는 프로세스의 상태, PID, program counter(프로세스 작업 처리를 위해 다음 명령어의 주소를 저장), 프로세스 스케줄링을 위한 우선순위 등의 프로세스에 관한 여러 정보들이 저장된다. 프로세스에서 상태 전이가 일어날 때 운영체제는 가장 최근 실행으로 변경된 데이터를 PCB에 업데이트한다. 그리고 context switching에 의해 다음 프로세스를 CPU가 실행하고자 할 때 해당 프로세스의 PCB에 기록된 정보들을 먼저 불러와 파악하고, 이전에 중단되었던 작업 시점부터 다시 재개한다. 여기서 PCB는 마치 게임 세이브 기록과 같은 역할을 한다고 보면 되겠다.
PCB에 담기는 정보에는 다음과 같이 존재한다.
- Pointer: 프로세스의 현재 메모리 상의 위치를 저장하는 포인터 정보.
- Process state: 프로세스의 상태 정보를 저장. 후술할 “프로세스의 상태 전이” 챕터에서 언급할 프로세스가 가질 수 있는 5가지 상태 중 현재 프로세스가 어떤 상태인지를 저장한다.
- Program counter: 다음에 프로세스 내에서 실행될 다음 명령어의 메모리 주소를 저장한다.
- PID(Process ID): 서로 다른 프로세스들을 구분하기 위해 각 프로세스마다 고유하게 부여되는 숫자.
- Register: context switching이 일어날 때 현재 프로세스에 대한 CPU register에 담긴 정보들을 저장한다.
- Memory limits: 운영체제에 의해 사용되는 메모리 관리 시스템에 관한 정보들이 저장되는 곳. page table 등이 그 예이다.
- List of open files: 프로세스에 의해 열린 파일 목록.
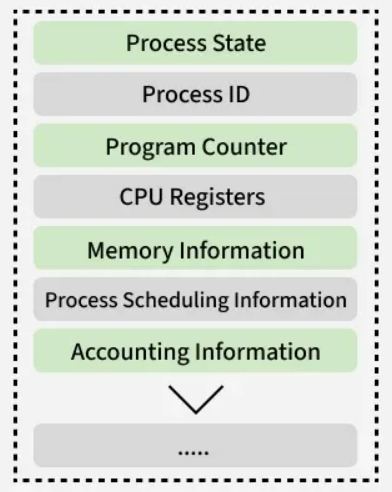
참고 사진 2-1. PCB에 저장되는 정보들을 시각화한 그림.
출처: https://www.geeksforgeeks.org/operating-systems/process-control-block-in-os/
프로세스의 PCB와 비슷하게 스레드의 정보를 기록, 저장하는 곳인 TCB(Thread Control Block)도 존재한다. 각 스레드의 정보들을 담은 자료구조로, 다중 스레드에 대한 context switching이 일어날 때에도 똑같이 필요하다. 하나의 프로세스 안에 여러 스레드가 포함될 수 있듯, TCB는 PCB 안에 들어 있는 구조를 취한다. TCB도 PCB처럼 스레드에 관한 여러 정보들을 저장한다. 다만, 스레드는 프로세스에 있는 heap, code, data 메모리 영역을 공유하여 사용하므로 TCB는 PCB에 비해 조금 더 가볍다. 그래서 같은 context switching이라도 다중 프로세스 환경보다는 다중 스레드 환경에서 context switching에 의한 overhead가 덜하다.
Multi-process
Multi-process라 함은, 여러 프로세스들을 동시에 실행시키는 것을 의미한다.
“여러 프로세스”라 하면 여러 프로그램들로부터 각자 생성된 프로세스들일 수도 있지만, 하나의 동일한 프로그램으로부터 여러 프로세스들을 생성할 수도 있다. 또한, 하나의 프로세스에서 또 다른 프로세스를 생성할 수도 있다. 이 때 다른 프로세스를 생성한 프로세스를 부모 프로세스(parent process), 부모 프로세스에 의해 생성된 프로세스를 자식 프로세스(child process, subprocess, subtask)라 부른다.
부모 프로세스로부터 자식 프로세스를 생성하기 위해선 fork() 라는 시스템 콜을 호출한다. 부모 프로세스에서 해당 함수를 호출할 때, 호출에 성공한다면 해당 함수의 반환값으로 자식 프로세스의 PID를 반환한다. 반면 현재 프로세스가 자식 프로세스일 경우에는 0을 반환한다. 한 편 fork() 호출에 실패한 경우 부모 프로세스에서는 -1이 반환되며 자식 프로세스는 생성되지 않는다. 이를 이용하면 각 상황마다 적절한 대처를 할 수 있을 것이다.
다음은 이러한 점을 이용하여, 하나의 코드 스니펫에서 부모 프로세스일 때와 자식 프로세스일 때의 실행 결과가 어떻게 나오는지를 보는 C 언어 코드 예시이다.
#include <sys/types.h>
#include <stdio.h>
#include <unistd.h>

// Driver code
int main()
{
  int pid;
  pid = fork();

  if (pid == 0)
  {
    printf ("Child : I am the child process\n");
    printf ("Child : Child’s PID: %d\n", getpid());
    printf ("Child : Parent’s PID: %d\n", getppid());
  }
  else
  {
    printf ("Parent : I am the parent process\n");
    printf ("Parent : Parent’s PID: %d\n", getpid());
    printf ("Parent : Child’s PID: %d\n", pid);
  }
}
코드 1-1. C언어에서 fork() 시스템 콜 호출을 통해 자식 프로세스를 만들고, 부모인지 자식인지에 따라 실행 분기를 나눈 코드 예시. 코드 출처: https://www.geeksforgeeks.org/dsa/difference-between-process-parent-process-and-child-process/
Child : I am the child process
Child : Child's PID: 4706
Child : Parent's PID: 4705
Parent : I am the Parent process
Parent : Parent's PID: 4705
Parent : Child's PID: 4706
코드 1-2. 코드 1-1의 실행 결과 예시
위 코드에서, fork() 함수 호출 결과가 0이라면 이는 현재 실행 중인 프로세스가 자식 프로세스라는 뜻으로, pid == 0 분기점의 코드만을 실행하게 된다. 반면 0이 아니라면 이는 현재 실행 중인 프로세스가 부모 프로세스라는 의미로, 그 반환값은 자식 프로세스의 PID이며, 이를 통해 부모 프로세스만의 작업을 할 수도 있고, 자식 프로세스를 통제할 수도 있는 것이다. 실제로 두 프로세스는 서로의 PID를 알고 있어 서로 간의 통신을 할 때 용이하다.
그러나 메모리 영역의 관점에서는 이 두 프로세스는 서로 분리되어 있다. 두 프로세스 모두 각자의 code, heap, stack, data 영역을 독립적으로 보유하고 있다. 다만, 처음 부모 프로세스로부터 자식 프로세스가 생성될 때, 부모 프로세스가 갖고 있는 대부분의 특성들이 자식 프로세스에게 복사된다.
부모 - 자식 프로세스에서 프로세스들의 관계 및 상태에 따라 여러 종류가 발생한다.
- init 프로세스: 최상위 프로세스로, 부팅 시 가장 먼저 실행되어 시스템 전반의 설정을 초기화한다.
- 고아(orphan) 프로세스: 자식 프로세스보다 부모 프로세스가 먼저 삭제, 종료되었을 때의 자식 프로세스를 의미한다. 이 경우, 최상위 프로세스인 init 프로세스에서 이 고아 프로세스를 관리하게 된다.
- 좀비(zombie) 프로세스: 자식 프로세스의 종료 신호를 부모 프로세스가 처리하지 못한 경우의 자식 프로세스. 프로세스 종료 시 해당 프로세스가 차지하고 있던 자원은 운영체제가 회수해가지만, 프로세스 상태가 기록되는 process table에서는 해당 프로세스 정보가 남아있을 수 있다. 이 상태의 프로세스를 좀비 프로세스라 한다. 마치 책의 본문에서 특정 내용이 있는 부분을 직접 지웠지만, 책의 목차에서는 해당 챕터를 지우지 않은 것과 비슷하다고 보면 된다.
- 이를 사전에 방지하려면 부모 프로세스가
wait()라는 시스템 콜을 호출하여 자식 프로세스가 종료할 때까지 기다리도록 해야한다. 이 시스템 콜을 사용하면 자식 프로세스의 관리 정보도 같이 삭제된다.
- 이를 사전에 방지하려면 부모 프로세스가
이러한 멀티 프로세스 방식은 각 프로세스마다 독립적인 메모리 영역을 가지면서도, 부모 - 자식 프로세스를 이용하여 서로 연관 있는 작업들을 동시에 수행하고자 할 때 활용할 수 있다. 예를 들어, 어떤 프로그램을 처음 컴퓨터에 설치할 때 많이 보는 것이 바로 현재 설치 상태를 프로그레스 바로 보여주는 것이 있겠다. 여기서는 실제로 설치 관리자가 프로그램을 컴퓨터에 설치하는 작업과, 현재 설치 작업이 어디까지 진행되었는지를 표시하는 작업으로 나뉘는데, 이 두 작업은 서로 연관있는 작업이므로, 서로 다른 프로그램으로 제작하여 실행하는 방식으로는 해결하기 힘들다. 그래서 같은 프로그램 내에서 두 작업을 각자 별도로 수행하는 멀티 프로세스 방식을 도입하여 이 두 작업을 동시에 수행하도록 할 수 있다. 예를 들어 실제 프로그램 설치 작업은 부모 프로세스가, 현재 설치 상태를 프로그레스 바로 나타내는 작업은 자식 프로세스가 하도록 설정할 수 있다. 그러면서도 만약 프로그레스 바 작업에 문제가 생겼을 때, 프로그램 설치 작업에 영향을 주지 않으므로 설치 작업은 문제없이 그대로 실행시킬 수 있다는 장점도 있다. 만약 이를 멀티 프로세스가 아닌 멀티 스레드로 구현했다면 스레드는 같은 메모리 영역을 공유하기에 자칫 한 작업에서의 문제가 다른 작업에까지 퍼져 프로그래스 바에 문제가 생겼다는 이유로 프로그램 설치까지 먹통이 되는 불상사가 발생할 수도 있는 것이다.
멀티 프로세스의 또 한 가지 좋은 예는 바로 브라우저이다. 크롬과 같은 동일한 브라우저에서 여러 탭들을 켜놓을 때가 많을 텐데, 실제로 내부에서는 각 탭을 생성할 때마다 별도의 프로세스를 생성하는 방식을 취한다고 한다. 이렇게 하는 이유는 역시나 하나의 탭에서 문제가 생겼다는 이유로 다른 탭에까지 그 문제의 악영향이 끼치지 않도록 하기 위함이다.
서버 용도로 사용하기 위한 하나의 물리적 컴퓨터 내에서 네트워크 트래픽을 분산시키기 위해 여러 서버들을 생성할 때에도 멀티 프로세스 방식을 사용할 수 있다. 서로 똑같은 프로세스들을 여러 개 생성함으로써 요청 분산에 따른 응답 속도 향상, 시스템 규모 확장성 확보, 하나의 서버 프로세스가 다운되어도 다른 서버 프로세스들은 멀쩡하다는 안정성을 확보할 수 있다.
이처럼 멀티 프로세스 방식을 사용한다면 서로 영향을 끼치지 않아야 하는 독립적인 작업들을 안정성 있게 동시에 실행시킬 수 있으며, 원한다면 똑같은 프로세스들을 더 생성하여 시스템 규모 확장에도 용이하다.
다만, 멀티 프로세스는 멀티 스레드에 비해 단점도 있다. 먼저 상대적으로 context switching에 따른 overhead가 심하다는 것이다. 멀티 스레드 방식에서는 이 overhead가 상대적으로 가볍다. 그래서 멀티 태스킹의 효과를 극대화하고, 더 빠른 동시 처리를 위해선 멀티 스레드 방식을 고려하는 것이 좋겠다.
또한, 멀티 스레드에서는 동일한 프로세스의 자원을 쉽게 공유할 수 있지만, 멀티 프로세스 방식에서는 각자 독립적인 메모리 영역을 가지고 있기에 서로 통신하려면 IPC와 같은 상대적으로 복잡한 다른 기술을 사용해야만 한다. 또한, 프로세스마다 독립적인 메모리 영역을 가진다는 건, 프로세스의 수를 늘릴수록 멀티 스레드 환경에 비해 더 많은 메모리를 잡아먹는다는 뜻이다. 따라서 상대적으로 메모리 공간의 부족함으로 인해 다중 프로그래밍의 효과를 제대로 보기 힘들다.
물론 멀티 스레드에도 단점이 있다. 같은 프로세스의 메모리 영역을 공유하다보니 상대적으로 deadlock이 더 자주 발생할 수도 있고, 공유 데이터가 쉽게 오염될 수 있어 좀 더 섬세한 프로그래밍을 필요로 한다. 공유 데이터가 쉽게 오염될 수 있다는 특성 때문에 멀티 스레드 환경에서는 공유 데이터의 오염을 방지하기 위해 스레드 간 동기화(synchronization)가 필요할 때가 많을 것이다. 즉, 특정 자원에 대해서는 여러 스레드들이 차례대로 줄서서 순차적으로 접근하게끔 하는 방법이다. 그러나 이는 스레드의 동시성 효과를 제대로 못 누려 전체적인 성능 및 속도가 저하된다는 문제점도 있다.
또한 앞서 말했듯, 메모리 공간의 공유 때문에 하나의 스레드에서 문제가 발생하면 그 문제가 다른 스레드에도 퍼질 수 있어, 각 작업 간 독립성 및 안정성이 필요할 때에는 부적절할 수 있다.
참고 - 운영체제의 세대별 발달 과정
- 1세대: 일괄 처리 시스템(batch processing system) - 하나의 작업이 끝나기까지 다른 작업을 할 수 없는 구조의 시스템.
- 2세대
- 시분할 시스템(time sharing system) - 다중 사용자들이 공유 컴퓨터에서 각자 사용하는 프로그램들을 번갈아가며 처리하는 시스템.
- 다중 처리 시스템(multi-processing system) - 하나의 컴퓨터에 여러 CPU를 두어 병렬로 처리하는 시스템
- 3세대: 범용 시스템 - 특정 용도로만 컴퓨터를 사용하지 않고, 메모리에 적재되어 실행되는 여러 프로그램들을 여러 용도로 사용하는 시스템.
- 4세대: 분산 처리 시스템 - 서로 다른 장소에 위치한 컴퓨터들에 기능, 자원을 분산시키고 상호 협력하는 시스템.
프로세스의 메모리 할당 기법
지금까지는 프로세스들을 직접 물리적 메모리에 적재하여 실행시키는 것을 전제로 하여 설명하였다. 그런데 컴퓨터를 살 때에도 알겠지만, SSD, HDD와 같은 디스크 저장용량에 비해 RAM 용량은 상대적으로 적은 것을 알 수 있다. RAM 용량에 비해 적은 수의 프로그램만 돌린다면 문제는 없겠지만, 너무 큰 용량의 프로그램을 실행하거나 아니면 너무 많은 프로그램들을 동시에 실행할 때에는 이 모든 프로그램들을 다 물리적 메모리에 적재할 수는 없을 것이다. 그래서 나중에는 이를 해결하는 방법까지도 나오게 되었다.
이 문제를 해결하는 방법을 설명하기에 앞서, 우선 프로세스를 메모리에 할당하는 기법에 대해 잠시 살펴보자. 크게 다음과 같이 2가지가 있다.
- 연속 할당 기법
- 프로세스를 메모리 공간에 연속적으로 적재, 할당하는 방법. 이로 인해 물리 메모리보다 큰 프로세스는 메모리에 적재하여 실행할 수 없다는 단점이 있다.
- 세부 종류
- 단일 분할 할당 기법 - overlay, swapping 등
- 다중 분할 할당 기법 - 고정 분할 할당 기법, 동적 분할 할당 기법
- 분산 할당 기법
- 하나의 프로세스를 여러 조각으로 나눠 메모리 공간에 분산시켜 배치시키는 기법. 이를 수행하기 위해 주로 가상 메모리 시스템을 사용한다.
- 세부 종류
- paging 기법
- segmentation 기법
- paging - segmentation 혼용 기법
다음 챕터에서는 이 중에서 가상 메모리 시스템 및 페이징 기법에 집중하여 설명하도록 하겠다.
가상 메모리 시스템 (Virtual memory system)
가상 메모리는 제한된 물리적 메모리의 용량보다 더 큰 메모리 용량을 가진 것처럼 보이게 하는 기술로, 이를 위해 물리적 메모리 뿐만 아니라 디스크의 일부 용량까지 활용한다. 이러한 기술 덕분에 실제 물리적 메모리의 용량보다 더 큰 프로그램도 실행할 수 있게 된다. 우리가 알고 있는 메모리가 물리적 메모리라면, 가상 메모리는 논리적 메모리라 볼 수 있다.
가상 메모리 시스템을 이용하면 물리적 메모리 뿐만 아니라 하나의 가상 메모리 영역이 따로 존재하게 된다.
가상 메모리 시스템에서는 프로세스가 직접 물리적 메모리의 주소를 참조하지 않는다. 대신 가상 메모리 영역에 있는 가상 주소(virtual address)를 참조하게 한다. CPU가 가상 주소를 통해 실제 메모리에 접근해야할 때에는 보통 CPU 내에 설치되어 있는 MMU(Memory Management Unit)라는 하드웨어에서 가상 주소를 물리적 메모리 주소로 변환하여 접근한다.
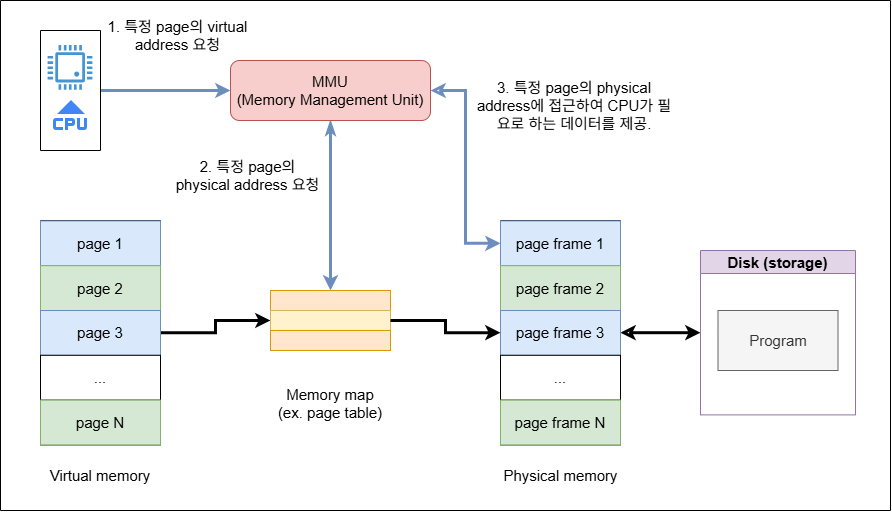
그림 6-1. 가상 메모리 시스템의 구조와 CPU가 MMU를 통해 특정 페이지 정보에 접근하는 과정을 그린 그림.
이렇게 별도로 가상 메모리를 두면 발생하는 이점들은 다음과 같다.
- 프로세스가 직접 물리적 메모리의 주소를 참조하지 않고 가상 메모리라는 논리적 영역에서 가상 주소를 부여함으로써 프로세스 간의 격리 수준을 보장할 수 있다. 만약 여러 프로세스들이 직접 물리적 메모리를 참조하게 한다면, 프로세스가 엉뚱한 다른 프로세스의 메모리를 참조할 수도 있는데, 가상 메모리 시스템에서는 이를 방지해준다.
- 가상 메모리라는 논리적 영역에서는 하나의 프로세스를 특정한 크기의 더 작은 단위로 (논리적으로)분할하고 분산 배치할 수 있다. 프로세스가 물리적 메모리에 직접 배치될 때에는 연속적으로 배치되는데, 이로 인해 물리적 메모리의 공간이 부족하여 다른 프로세스가 배치되기 어려워 다중 프로그래밍을 어렵게 만든다.
- 가상 메모리 시스템에서는 물리적 메모리 뿐만 아니라 디스크의 일부 영역도 메모리로 활용하기에 실제 물리적 메모리가 제공하는 용량보다 더 큰 프로세스들을 실행할 수 있게 된다.
페이징 (Paging)
앞서 프로세스의 메모리 분산 할당 기법에는 paging 기법과 segmentation 기법이 있다고 하였다.
paging 기법은 프로세스를 고정된 크기의 작은 단위로 나눠 메모리에 분산하여 배치하는 기법이다. 가상 메모리 영역에서는 page라고 하는 고정된 작은 크기로 나눠 배치하고, 물리적 메모리에서는 page frame이라고 하는 고정된 크기로 나눠 배치한다.
segmentation 기법은 프로세스를 구성하는 코드의 배열, 함수와 같은 논리적인 가변적 크기로 나눠 메모리에 분산 배치하는 기법이다.
즉, 두 기법은 프로세스를 고정된 크기로 나누느냐, 논리적인 가변적인 크기로 나누느냐의 차이로, 그 외에는 별 차이가 없으며, 프로세스를 조각 내어 메모리에 분산 배치한다는 점은 공통된 점이다.
필자가 참고한 여러 자료들에서는 대부분 segmentation보다는 paging 기법을 더 중점적으로 다루기에 필자도 paging에 대해서만 다루도록 하겠다.
paging 기법에서는 가상 메모리 영역에 있는 page와 물리적 메모리 영역에 있는 page frame 간의 메모리 주소 참조 매핑을 위해 별도로 page table이라는 자료 구조가 존재한다. 그래서 paging 기법에서는 CPU가 물리 주소를 참조하고자 할 때 MMU가 page table이라는 자료 구조가 존재하는 주소에 접근, 참조하여 물리 주소를 가져오는 방식이다.
페이지 교체
앞서 가상 메모리에 대해 다룰 때에는, 가상 메모리가 실제 물리 메모리의 용량보다 더 큰 용량을 제공하는 것처럼 해준다고 하였다. 페이징 기법을 사용할 때에는 이 효과를 어떻게 구현하는 걸까?
메모리에 페이지가 가득 차 더 이상 사용 가능한 공간이 없을 때, 이미 메모리 상에 존재하는 페이지들 중 현재 사용되지 않고 있는 페이지들을 찾아 메모리 상에서 내려버리고, 필요한 페이지를 디스크에서 찾아 메모리에 올리는 교체 기법을 사용한다. 즉, 페이징 기법은 가동 중인 프로세스에서 필요한 부분의 페이지만을 메모리에 적재하는 demand paging(요구 페이징) 기법6을 사용하여 물리적 메모리 용량의 한계를 극복한다.
메모리에 적재된 상태였다가 현재 사용되지 않아 교체 당하는 페이지는 그 정보가 디스크에 swap file이라는 파일 형태로 임시 저장된다. 그러다가 나중에 다시 이 페이지가 필요하게 되면 다시 메모리에 적재되는 방식이다. 이런 방식으로 가상 메모리 시스템 및 페이징 기법이 디스크의 일부까지 RAM처럼 활용하는 것이다.
참고로, 페이지를 구체적으로 어떤 방식으로 교체할지에 대한 알고리즘이 별도로 필요한데, 대략 다음과 같이 정리할 수 있다.
- FIFO(First In, First Out): 가장 먼저 메모리에 들어와 상대적으로 오랫동안 적재되어 있던 페이지를 먼저 교체하는 기법. 자료구조의 queue와 동일한 방식이라 보면 된다.
- LRU(Least Recently Used): 각 페이지들의 가장 최근에 사용된 시각들을 기록하여, 가장 오랫동안 사용되지 않은 페이지부터 교체하는 알고리즘. 참조 지역성(locality of reference)의 시간(temporal) 지역성에 따르면, 최근 사용된 메모리 공간이 집중적으로 사용되는 현상이 존재하며, 이로 인해 최근에 참조된 메모리 공간이 다음에도 참조될 확률이 높은 특성이 있는데, LRU는 이 특성을 이용한 알고리즘이다.
- LFU(Least Frequently Used): 각 페이지들의 사용 횟수를 카운팅하여 가장 적게 사용된 페이지를 먼저 교체하는 알고리즘.
- OPT(OPTimal replacement): 앞으로 가장 오랫동안 사용하지 않을 페이지 교체 기법으로, 페이지 부재(page fault)가 가장 적게 일어나는 알고리즘.
- NUR(Not Used Recently): 최근에 사용되지 않은 페이지를 교체하는 기법. LRU 알고리즘의 시간적 오버헤드를 줄일 수 있음.
- SCR(Second Chance Replacement): FIFO 기법의 문제점은, 자주 사용되는 페이지임에도 메모리에 가장 먼저 적재되었다는 이유로 교체당하기 쉽다는 것이다. SCR은 이 문제점을 보완하기 위한 기법으로, 가장 먼저 들어왔던 페이지이면서도 최근에 사용되지 않았을 때에만 교체하는 알고리즘.
페이징 기법의 문제점들
페이징 기법에서도 몇몇 문제점들이 발생한다.
메모리 단편화
메모리 단편화는 여러 조각으로 분할된 프로세스가 메모리 영역에 적재될 때 남아서 낭비되는 나머지 메모리 공간이 발생하는 현상을 의미한다. 단편화에는 내부 단편화와 외부 단편화가 있다.
- 내부 단편화: 메모리에 할당된 크기가 실제 적재된 프로세스 조각의 크기보다 커서 할당된 메모리 내부 공간이 남는 현상.
- 예) 프로그램의 크기가 21KB이고, 페이지 단위가 5KB일 때, 마지막 페이지 크기가 1KB가 남아버리므로, 마지막 페이지에서는 1KB만 적재되어 나머지 4KB가 사용되지 못하고 낭비된다.
- 프로세스의 조각 크기가 일정한 페이징 기법에서 나타난다. 페이징 기법에서는 내부 단편화만 일어나고 외부 단편화는 일어나지 않는다.
- 외부 단편화: 내부 단편화와는 반대로, 메모리에 할당된 공간의 크기보다 프로세스 조각의 크기가 더 커서 적재되지 못하고, 결국 해당 메모리 공간은 낭비되는 현상.
- 프로세스 조각 크기가 가변적인 세그먼테이션 기법에서 나타난다. 세그먼테이션 기법에서는 외부 단편화만 일어나고, 내부 단편화는 일어나지 않는다.
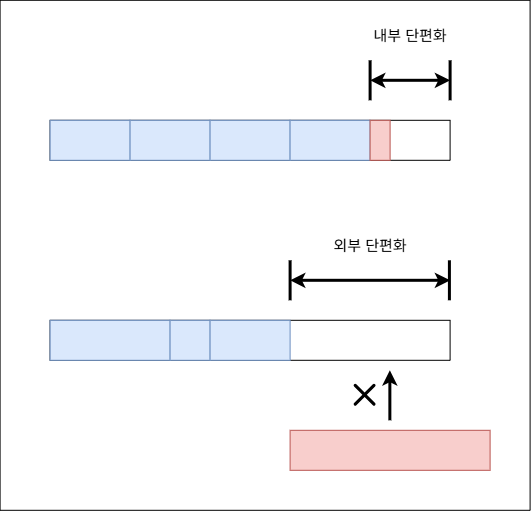
그림 7-1. 내부 단편화와 외부 단편화를 묘사한 그림. 내, 외부 단편화가 헷갈린다면 단순히 프로세스의 조각인 page, segmentation을 “블록, 퍼즐 조각”으로 생각하고, 할당된 메모리 영역을 블록을 담기 위한 “틀”이라고 보면 되겠다. 내부 단편화는 남은 블록의 너비가 남은 공간보다 짧을 때 발생하고, 외부 단편화는 남은 블록의 너비가 남은 공간보다 더 길어서 틀에 넣지 못할 때 발생한다고 보면 이해가 쉬울 것이다.
스레싱(Thrashing)
프로세스의 특정 페이지가 필요하지만 정작 메모리에 적재되지 않은 상태를 페이지 부재(page fault)7라 한다. 이 경우, 디스크로부터 직접 해당 페이지를 가져와 메모리에 적재해야하기에, 필요한 페이지가 이미 메모리에 적재되어 있는 상태보다 작업 처리 속도가 더 느려질 수밖에 없다. 이 때 특정 프로세스에서 지속적으로 페이지 부재가 발생하다보면 프로세스 처리 시간보다 페이지 교체 시간이 더 오래 걸리게 되는데, 이러한 현상을 스레싱(thrashing)이라 부른다. 이러한 스레싱은 전체 컴퓨터 시스템의 성능 저하로 이어진다.
하나의 CPU가 번갈아가면서 처리해야하는 프로세스의 수가 많아지면 CPU의 효율성은 어느 정도까지는 올라가지만, 처리해야하는 프로세스 수가 특정 임계점을 넘어서버리면 오히려 스레싱이 자주 발생하여 CPU의 효율성이 저하되어버리는 성질을 가지고 있다. 물리적 메모리의 용량은 한정되어 있는데 반해 동시에 가동하는 프로세스의 수가 너무 많아지기에 발생하는 현상이다.
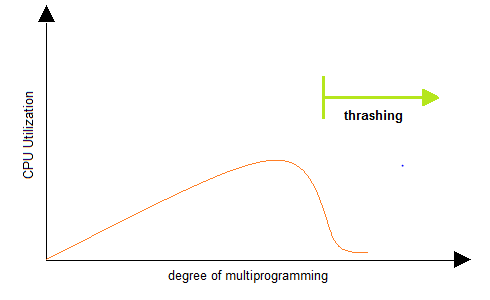
참고 사진 3-1. 다중 프로그래밍의 정도(degree of multiprogramming), 즉 한 번에 동시에 실행하는 프로세스의 개수에 따른 CPU 활용도를 그래프로 그린 그림. 어느 정도의 다중 프로그래밍 정도까지는 CPU 활용도가 올라가다가 어느 순간부터 갑자기 떨어지는 구간이 발생한다. 이 구간이 바로 스레싱이 벌어지는 구간이다.
사진 출처: https://www.ques10.com/p/3771/what-is-thrashing-3/
이러한 스레싱을 해결하는 방법에는 다음과 같이 존재한다.
- 워킹 세트(working set): 각 프로세스가 많이 참조하는 페이지들의 집합을 계속 메모리에 적재된 상태로 유지시켜 스레싱을 해결하는 방법. 프로그램의 참조 지역성 원리에 따라 최근에 접근되었던 메모리는 빠른 시간 안에 다시 참조된다는 특징을 이용한 방법.
- 장점: page hit가 높아짐에 따라 다중 프로그래밍 정도(degree of multi-programming)를 높일 수 있다. 즉 더 많은 프로그램들을 동시에 가동시킬 수 있다는 뜻이다. 이로 인해 CPU 활용도도 높일 수 있다.
- 단점: 워킹 세트, 즉 구체적으로 각 프로세스마다 어떤 페이지들이 집중적으로 참조되는지 추적 관리하기가 쉽지 않다. 워킹 세트의 크기를 어떻게 설정해야할지 모호하다.
- 페이지 부재 빈도(PFF, Page Fault Frequency): 페이지 부재율의 상한, 하한선을 정하고 실제 페이지 부재 비율에 따라 해당 프로세스에 할당할 페이지 프레임의 수를 조절하는 기법. 특정 프로세스의 페이지 부재율이 높아진다면 해당 프로세스에 페이지 프레임을 더 많이 할당시킴으로서 페이지 부재를 낮추고, 반대로 페이지 부재 비율이 낮다면 다른 프로세스를 위한 여유 메모리를 남기기 위해 페이지 프레임 수를 낮춘다.
- 장점: 페이지 부재가 발생할 때 실행하기에 부하가 적다. 직접 페이지 부재 비율을 조절할 수 있다.
- 단점: 새로운 페이지 프레임 할당 또는 반납을 위해 프로세스를 중단해야하는 과정이 발생한다. 또한, 페이지 적재를 위한 페이지 프레임의 개수가 가변적이기에, 참조 지역성에 따라 어떤 페이지가 더 자주 참조되는지가 바뀔 수 있어 생각보다 페이지 부재 방지가 잘 안될 수도 있다.
참고 - 지역성(Locality)
참조 지역성의 원리(Locality of reference)라고도 불리는 지역성은, 프로세스가 실행되는 동안 메모리 공간에 접근할 때 특정 메모리 공간만 집중적으로 접근하는 특성8을 의미한다. 이러한 지역성에는 다음과 같은 유형으로 나뉜다.
- 시간(Temporal) 지역성: 최근 접근했던 메모리 공간들에 대해서만 집중적으로 다시 접근하는 현상. 즉, 최근에 참조했던 메모리 주소는 빠른 시간 내에 다시 참조될 가능성이 높은 특성.
- 반복문, stack, 1씩 증감하는 카운팅 등의 요소에 의해 발견됨.
- 공간(Spatial) 지역성: 특정 위치에 접근되었던 메모리 주소의 인접한 주소에 접근하는 특성. 이로 인해 이전에 접근되었던 메모리 공간의 인접한 메모리 공간에 접근할 가능성이 높아진다.
- 배열 순회와 같이 관련 변수들을 메모리 공간 상에서 서로 근접하게 선언하고 접근할 때.
- 순차(Sequential) 지역성: 데이터가 순차적으로 접근되는 현상으로, 공간 지역성과 함께 묶여 설명되기도 한다.
이러한 지역성의 원리를 통해 메모리 접근 효율성을 높일 수 있는 가상 메모리, 워킹 세트, 캐시 메모리 등의 여러 기법들이 나올 수 있었다.
참고 - 지역성 원리에 따른 배열 VS 연결 리스트(Linked list), 그리고 정렬 알고리즘 link
배열은 그 요소들을 연속적이고 인접한 메모리 공간에 할당하는 자료구조이고, 반면 연결 리스트는 이를 구성하는 노드들이 메모리 공간상 인접한 곳에 할당된다는 보장이 없는 자료구조이다. 이러다보니 지역성의 원리를 따라 캐시 시스템을 구축했을 때, 연결 리스트 순회보다는 배열 순회가 더 캐시 히트율이 높기에 더 빠른 접근이 가능하게 된다. 물론 이건 공간 지역성의 원리를 이용한 것이기에, 아무리 배열이라 하더라도 순회가 아닌 매번 랜덤한 위치의 배열 요소에 접근하는 방식이라면 공간 지역성을 이용한 캐시 활용에 어려움을 겪을 수밖에 없을 것이다.
이와 비슷한 원리로, 정렬 알고리즘 중 시간복잡도 측면에서는 똑같이 \(O(NlogN)\)을 가지는 merge sort와 heap sort라도, merge sort는 서로 인접한 배열 요소들에 대해 비교 및 이동 연산을 하기에 공간 지역성의 원리를 잘 충족시키지만, heap sort의 경우, 연속적인 메모리 공간에 할당된 배열이라 하더라도 부모 - 자식 요소를 찾기 위해 현재 인덱스의 2배 더 크거나 작은 요소에 접근해야하므로, 서로 인접하지 않고 멀리 떨어진 요소들에 자주 접근하기에 공간 지역성의 원리를 충족시키지 않아 상대적으로 cache hit가 되지 않는다. 따라서 heap sort보다는 merge sort가 조금 더 빠르다. 그래서 동일한 \(O(NlogN)\) 을 가지는 정렬 알고리즘 중 가장 빠르다고 알려진 Tim sort에서는 서로 인접한 배열 요소들에 접근하는 insertion sort와 merge sort를 혼합하여 사용한다.
프로세스 관리
이전 내용들을 큰 틀에서 보면, 하나의 컴퓨터 시스템에서 동시에 여러 프로그램들을 원활하게 실행하기 위한 방법들을 소개했다고 볼 수 있다. 한정된 물리적 자원에서 해결해야하다보니 자연스레 프로세스는 생성 - 실행 - 종료의 단순한 생명주기가 아닌 조금 더 복잡한 생명주기를 가지게 된다. 더군다나 다중 프로그래밍을 위해선 어떤 프로세스들을 어떤 방식으로 우선순위를 부여해 먼저 처리할지에 대한 스케줄링 기법도 필요하게 된다. 이 챕터에서는 한정된 컴퓨팅 자원을 가지는 하나의 컴퓨터에서 다중 프로그래밍을 원활하게 실행하기 위해 필요한 프로세스의 관리 방법에 대해 살펴보고자 한다.
프로세스의 상태 전이 (State transition of process)
프로세스는 상황에 따라 여러 상태들 중 하나의 상태를 가질 수 있으며, 시간이 지남에 따라 다른 상태로 전이할 수 있다. 보통 5개의 상태로 설명되는데, 이 모델의 경우 각 상태들은 다음과 같다.
- 생성(create, new): 사용자의 호출에 의해 프로세스가 이제 막 생성된 단계로, 아직 실행 단계는 아니지만, 해당 프로세스의 정보들이 담길 PCB는 준비되는 상태이다.
- 준비(ready): 프로세스가 메모리에 적재되어 CPU에 의해 할당될 준비가 된 상태. 이 상태의 프로세스는 준비 리스트(ready list)에서 대기한다.
- 실행(running): 준비 상태에 놓인 프로세스가 CPU에 의해 할당받아 실행되는 상태. 하나의 CPU 코어는 한 번에 단 하나만의 프로세스를 처리할 수 있기에, 만일 싱글 CPU 코어 시스템이라면 이 “실행” 상태에 놓이게 되는 프로세스는 한 번에 단 한 개 뿐이다.
- 대기(waiting, block): 프로세스 실행 도중 데이터 입출력 처리 등의 이벤트 발생에 의해 그 결과를 기다려야 하는 상황이 오는 경우, 해당 프로세스는 일시적으로 CPU 할당을 해체하고 대기 리스트(waiting list)에서 대기하는 상태. I/O 등의 작업이 끝나는 대로 대기 상태에 놓인 프로세스는 다시 준비 상태로 돌아가 CPU에 할당받기 위해 대기하게 된다. 대기 상태에 있던 프로세스의 I/O 처리가 완료되더라도 그 시점에서 CPU는 다른 프로세스를 할당받아 처리하고 있을 수도 있기에 대기 상태에서 바로 실행 상태로 가는 것이 아니라 준비 단계로 돌아가는 것이다.
- 완료(completed, terminated, exit): CPU에 할당받아 실행 중이던 프로세스가 주어진 시간 내에 작업을 완료 또는 중단하여 종료된 상태. 이 상태에서 프로세스는 OS에 의해 메모리에서 제거된다.
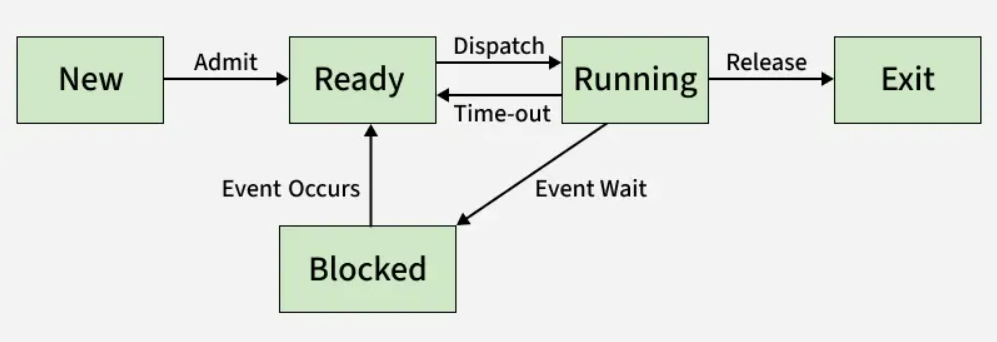
참고 사진 4-1. 프로세스의 상태 전이 그림. 출처: https://www.geeksforgeeks.org/operating-systems/states-of-a-process-in-operating-systems/
하나의 상태에서 다른 상태로 전이될 때의 조건 또는 그 과정에서 벌어지는 일들은 다음과 같다.
| 상태 전이 | 명칭 | 설명 |
|---|---|---|
| 준비 → 실행 | 디스패치(dispatch) | 준비 상태에 놓인 여러 프로세스들 중 실행할 프로세스를 선정(scheduling)하여 CPU에 할당한다. 여기서 context switching이 발생한다. |
| 실행 → 준비 | time-out, timer run out, 할당 시간 초과 | 프로세스마다 지정된 시간 할당량(time quantum)이 초과될 때, 또는 선점형 스케줄링(preemptive scheduling)에 의해 다른 프로세스에 의해 CPU를 선점당할 경우, 스케줄러에 의해 PCB 저장 후 CPU를 반납하여 프로세스가 실행 단계에서 준비 단계로 회귀한다. |
| 실행 → 대기 | block(입출력 발생) | 실행 상태인 프로세스에서 I/O 또는 그 외 이벤트가 발생하여 그 결과를 기다려야 하는 경우, 프로세스는 할당받은 CPU를 반납하고, 해당 이벤트가 처리될 때까지 대기 상태로 전이된다. 즉시 실행할 수 없는 system call, I/O 작업, IPC(프로세스 간 통신) 등의 이벤트에서 발생한다. |
| 대기 → 준비 | wake-up(깨움) | 입출력, 이벤트가 종료되면 대기 상태에 있던 프로세스에게 OS가 해당 이벤트 종료를 통지하고, 대기 상태이던 프로세스가 준비 상태로 전이된다. |
만약 어떤 컴퓨터에서 degree of multiprogramming이 100까지 지원한다면, 즉, 한 번에 100개의 프로세스들을 띄울 수 있는 시스템이라면, 이는 곧 최대 100개의 프로세스들이 준비 상태, 즉 준비 리스트에 담길 수 있다는 뜻이기도 하다.
프로세스 스케줄링 (Process scheduling)
다중 프로그래밍을 위해선 여러 프로세스들 중 어떤 프로세스가 먼저 CPU에 할당될지 그 우선순위를 결정하고 관리하는 스케줄링(scheduling)이 필요할 것이다. 이 또한 운영체제에서 담당한다. 이러한 프로세스 스케줄링은 처리율(throughput) 향상, CPU 활용의 효율성을 증가시키고, 대기 시간, 응답 시간 등의 여러 오버헤드를 줄이기도 한다.
우선 프로세스 스케줄링과 관련된 용어들을 정리하자면 다음과 같다.
- 서비스 시간(수행 시간, Burst time): 프로세스가 결과를 산출하기까지 소요되는 시간.
- 응답 시간(Response time): 프로세스가 서비스를 요청하고, 그에 반응하기 시작할 때까지 걸리는 시간.
- 대기 시간(waiting time): 프로세스가 프로세서(CPU)에 할당되기까지 큐에 대기하는 시간. 프로세스가 큐에 들어가자마자 즉시 프로세서에 할당된다면 대기 시간은 0이다.
- 반환 시간(Turnaround time): 프로세스가 할당되어 서비스를 수행하고 결과 산출까지 걸리는 시간.
반환 시간 = 대기 시간 + 수행 시간
- 평균 대기 시간(Average waiting time): 프로세스들이 준비 큐에서 대기하는 평균 시간.
- 종료 시간(End time): 프로세스가 요구하는 서비스 요청을 모두 수행하고 종료된 시간
- 시간 할당량(Time quantum, time slice): 한 프로세스의 프로세서 독점을 방지하기 위해 할당되는 CPU 점유 시간.
- 응답률(Response Ratio):
(대기 시간 + 서비스 시간) / (서비스 시간)으로 계산됨.
프로세스 스케줄링에는 두 가지 유형이 있다.
- 선점형 스케줄링(Preemptive scheduling): 이미 하나의 프로세스가 CPU를 차지하고 있을 때 우선순위가 더 높은 다른 프로세스가 현재 프로세스를 중단시키고 CPU를 점유하는 방식. 즉, 이미 CPU가 프로세스를 처리하고 있더라도 다른 프로세스가 언제든지 CPU를 가로챌 수 있는 방식. 각 프로세스마다 일정한 시간 할당량을 부여하는 멀티 태스킹, 시분할 방식이 이러한 스케줄링 방식을 띈다.
- 장점: 특정 프로세스만 CPU 자원을 독점할 일을 방지할 수 있다. 비교적 빠른 응답이 가능하여 실시간 응답 환경에 유리하다.
- 단점: 높은 우선순위를 가지는 프로세스들이 CPU를 가로챌 경우 context switching이 발생하여 이로 인한 overhead가 발생할 수 있다.
- 비선점형 스케줄링(Non preemptive scheduling): 일단 한 프로세스가 CPU를 점유하고 있을 때에는 다른 프로세스가 해당 CPU를 가로챌 수 없는 방식.
- 장점: 응답 시간 예상이 용이. 모든 프로세스의 요구들을 공정하게 처리할 수 있다.
- 단점: 긴 수행 시간을 필요로 하는 프로세스가 CPU를 점유하는 동안 짧은 수행 시간을 필요로 하는 프로세스는 계속 대기해야한다.
선점형 스케줄링 방식에서 사용할 수 있는 알고리즘에는 다음과 같이 존재한다.
- SRT(Shortest Remaining Time first): 가장 짧은 시간이 소요되는 프로세스를 먼저 수행하되, 중간에 준비 큐에 들어오는 프로세스의 남은 처리 시간이 더 짧을 경우 해당 프로세스가 선점하는 방법.
- MLQ(Multi Level Queue, 다단계 큐): 작업을 여러 종류의 그룹으로 분할, 여러 개의 큐를 이용하여 상위 단계 작업에 의해 하위 단계 작업이 선점 당하는 기법. 각 큐는 독립적인 스케줄링을 가진다.
- RR(Round Robin): 모든 프로세스들에 대해 동일한 크기의 시간 할당량을 부여하고, 프로세스가 시간 할당량 내에 처리하지 못할 경우 준비 큐로 보내지고, CPU는 다음 프로세스를 처리하도록 하는 기법. 가장 공평하게 모든 프로세스들을 처리하는 방법이라 할 수 있겠다.
- MLFQ(Multi Level Feedback Queue, 다단계 피드백 큐): 새로운 프로세스는 높은 우선순위를 부여하되, 실행 시간이 길어질수록 더 낮은 우선순위를 부여하도록 한다. 그리고 마지막에는 라운드 로빈 방식을 적용하는 기법. 입출력, CPU 위주인 프로세스 특성에 따라 큐마다 서로 다른 CPU 시간 할당량을 부여한다. FIFO와 라운드 로빈 기법을 합친 방식.
비선점형 스케줄링 알고리즘에는 다음과 같이 존재한다.
- FCFS(First Come, First Service, FIFO): 프로세스가 준비 큐에 도착한 순서대로 CPU를 할당하는 기법.
- Priority(우선순위): 프로세스 별로 우선순위가 주어지며, 그 우선순위에 따라 CPU를 할당하는 기법. 동일 순위가 발생할 때에는 FCFS 방식을 적용한다. 주요 또는 긴급 프로세스에 대한 우선 처리 및 설정과 자원 상황에 따른 우선순위 선정이 가능하다.
- Deadline(기한부): 명시된 기한 내에 프로세스의 작업이 완료되도록 계획하는 기법.
- SJF(Shortest Job First): 프로세스가 도착하는 시점에 가장 작은 수행 시간을 가진 프로세스가 종료 시점까지 CPU를 점유하도록 하는 기법.
- 준비 큐에 있는 가장 작은 수행 시간을 가진 프로세스들만 처리하다보면 그 시점마다 상대적으로 수행 시간이 많이 남아 있던 프로세스는 최악의 경우 무한정 준비 큐에서 기다려야만 할 수도 있다. 시스템 부하가 많은 경우에 이러한 현상이 두드러지는데, 이러한 현상을 기아 현상(starvation)이라고 한다.
- HRN(Highest Response ratio Next): 대기 중인 프로세스들 중 현재 응답률(Response Ratio)이 가장 높은 프로세스에 가장 높은 우선순위를 부여하여 먼저 처리되게끔 하는 기법.
- 응답률, 즉 HRN에서 우선순위를 결정하는 공식은
(대기 시간 + 서비스 시간) / (서비스 시간)으로 결정한다. - 긴 작업과 짧은 작업 간의 불평등을 완화하여 SJF의 단점인 기아 현상을 보완한 기법.
- 응답률, 즉 HRN에서 우선순위를 결정하는 공식은
교착상태 (Deadlock)
다중 프로세싱 환경에서 둘 이상의 프로세스가 특정 자원 할당을 계속 기다려서 결국 두 프로세스 모두 아무것도 하지 못하게 되는 상황을 교착 상태(Deadlock)라 한다. 이러한 교착 상태가 발생하지 않도록 예방하거나 해결하는 주체 역시 프로세스를 관리하는 운영체제의 역할이다.
교착상태가 발생하는 조건은 다음과 같으며, 다음 조건들을 모두 충족시켜야 교착상태가 발생한다.
- 상호 배제(Mutual exclusive): 프로세스가 자원을 배타적으로 점유하여 다른 프로세스가 그 자원을 사용할 수 없는 상태.
- 점유와 대기(Hold and wait): 한 프로세스가 자원을 점유하고 있는 동시에 다른 자원도 요청하여 대기하는 상태.
- 비선점(Non-preemption): 프로세스가 어떤 자원을 점유하고 있을 때에는 다른 프로세스가 이를 강제로 뺏을 수 없는 상태.
- 환형 대기(Circular wait): 둘 이상의 프로세스 간 자원의 점유와 대기가 하나의 원형을 구성하고 있는 상태. 즉, 뱀의 머리가 자신의 꼬리를 물고 있듯 둘 이상의 여러 프로세스들이 다음 자원을 요구 및 대기하고 있는 상태.
이러한 교착 상태를 해결하는 방법에는 다음과 같은 방법들이 있다.
- 예방(Prevention): 교착 상태 발생 조건 4가지 중 한 가지만을 충족시키지 못하게 하는 방법으로, 교착상태를 예방하도록 제어하는 방법.
- 예) 한 프로세스가 점유한 자원을 할당 해체하고 새 자원을 요청하도록 한다.
- 회피(Avoidance): 교착 상태 없이 안전한 상태를 유지할 수 있는 자원 요청만 수락하도록 하는 방법.
- 발견(Detection): 감시 알고리즘을 통해 시스템의 상태를 검사하여 교착상태를 탐지하는 방법.
- 복구(Recovery): 교착 상태가 없어질 때까지 프로세스들을 순차적으로 하나씩 강제 종료(kill)하거나, 자원을 선점(preemptive)하게 하여 회복하는 방법.
한 편, 교착상태라는 것은 multi-processing 환경에서 뿐만 아니라 multi-threading 환경에서도 발생한다. 다중 스레드 환경에서는 각 스레드들이 소속되어 있는 프로세스의 stack 영역을 제외한 나머지 모든 메모리 영역을 공유하기에 더 빈번하게 교착상태가 발생한다.
관련 참고할만한 이전 글
글을 마치며
처음에 “[Docker] 웹 앱을 로컬에서 도커로 띄워보기 예시”라는 글에서 다뤘던 것처럼 3 tier architecture 구조를 가지는 웹 앱을 로컬에서 도커로 띄워보는 실습을 할 당시 웹 서버로 nginx를 선택했는데, 이 nginx에 대해 알아보던 중, “전통적인 웹 서버에서는 수많은 동시 접속자들의 요청을 해결하기 위해 각 요청마다 별도의 프로세스 또는 스레드를 생성, 할당하여 처리하도록 하였다. 그러나 이는 스레싱 등의 여러 문제를 발생시켰다”라는 구절을 보았었다. 필자는 이를 제대로 이해하기 위한 기초 자료로서 이 글을 작성하게 된 것이다.
이 글에서 작성된 다중 프로그래밍 환경에서의 프로세스 관리와 그로 인해 생기는 문제들을 해결하는 주체는 모두 운영체제가 담당한다. 프로세스 스케줄링도, 스레싱 문제 해결도 모두 운영체제가 관리하는 영역이다.
References
[1] 윤영빈 외 3인, “수제비 2025 - 정보처리기사 실기 기본서”, vol. 2, ch 11-1.
[2] 1.2.4. 가상 메모리 (Virtual Memory) 페이징 단편화 세그먼트
[3] 가상 메모리(Virtual Memory), 페이징(Paging)
[4] 가상 메모리 (Virtual Memory) - 운영체제(OS) 부트캠프 | 잔재미코딩
[5] 👩💻 멀티 태스킹 & 멀티 프로세싱 개념 한방 정리
[6] 04-2 다중 코어 프로그래밍
[7] 다중 프로그래밍
[8] Multiprogramming in Operating System - GeeksforGeeks
[10] Virtual Memory in Operating System - GeeksforGeeks
[11] Difference between Concurrency and Parallelism - GeeksforGeeks
[12] 프로세스 - 위키피디아
[13] 프로세스 관리 - 위키피디아
[14] 나무위키 - 프로세스(컴퓨터 공학)
[15] 👩💻 완전히 정복하는 프로세스 vs 스레드 개념
[16] Process Control Block in OS - GeeksforGeeks
[17] Process in Operating System - GeeksforGeeks
[18] Process vs Thread - GeeksforGeeks
[19] Introduction of Process Management - GeeksforGeeks
[20] Difference between Job, Task and Process - GeeksforGeeks
[21] Multitasking Operating System - GeeksforGeeks
[22] Multi Processing Operating System - GeeksforGeeks
[23] States of a Process in Operating Systems - GeeksforGeeks
[24] Thread Control Block in Operating System - GeeksforGeeks
[25] Difference Between Process, Parent Process, and Child Process - GeeksforGeeks
[26] 프로세스의 개념/정의, 프로세서의 개념/정의, 프로세스와 프로세서의 차이점, 프로세스의 종류 (데몬, 부모, 자식, 고아, 좀비 )
[27] [운영체제] 부모 프로세스(parent process)와 자식 프로세스(child process)
[28] [UNIX] 멀티 프로세스 (Multi Process) 프로그래밍
-
Random Access Memory ↩
-
Computer memory, primary memory ↩
-
CPU의 작업 수행 속도보다 I/O 작업 속도가 더 느린 편이다. ↩
-
CPU가 하나의 스레드를 처리하다가 다른 스레드를 처리하도록 context switching 하는 과정에서, 이전 스레드의 정보들을 TCB(Thread Control Block, PCB처럼 스레드의 정보를 저장하는 자료구조)에 저장한 후, 다음 스레드의 TCB로부터 해당 스레드의 정보를 불러와 작업을 처리하는 절차들이 포함되므로, 너무 과도한 context switching은 당연히 그 속도가 느려질 수밖에 없다. ↩
-
프로세스보다 스레드의 context switching의 속도가 상대적으로 더 빠르다고 한다. 메모리 관점에서 스레드의 경우 stack 영역을 제외한 나머지 data, heap, text 영역은 프로세스와 공유를 하기에 해당 영역들에 대한 정보는 PCB에 들어가고, TCB에는 stack 영역의 정보만 들어가기에 상대적으로 TCB가 더 가볍기 때문이다. ↩
-
이와 반대되는 개념으로 선행 페이징(pre-paging)이 있는데, 프로세스와 관련된 모든 페이지들을 메모리에 미리 적재하여 실행하는 방법이다. 그러나 이렇게 하면 페이징 교체 기법을 사용하더라도 불필요한 페이지들이 미리 메모리에 적재되어 있기에 페이지 교체가 더 잦게 일어날 것이고, 이로 인해 프로세스의 동작이 더 느려진다. ↩
-
참고로, 이와 반대로 CPU가 필요로 하는 페이지가 메모리에 이미 적재되어 있다면 이를 page hit라 부른다. 필요한 데이터가 캐시에 이미 저장되어 있을 때 cache hit라고 부르는 것과 같다. ↩
-
페이징 관점에서 설명하자면, 특정 페이지만 참조하는 특성을 의미한다. ↩
This content is licensed under
CC BY-NC 4.0


댓글남기기